Auditoría técnica SEO

Canibalización de keywords: cómo detectarla antes de que frene tu posicionamiento

Síntomas, causas y método de diagnóstico en sitios con catálogos amplios.
Lectura de 7 minutos Equipo SEO Ibérica
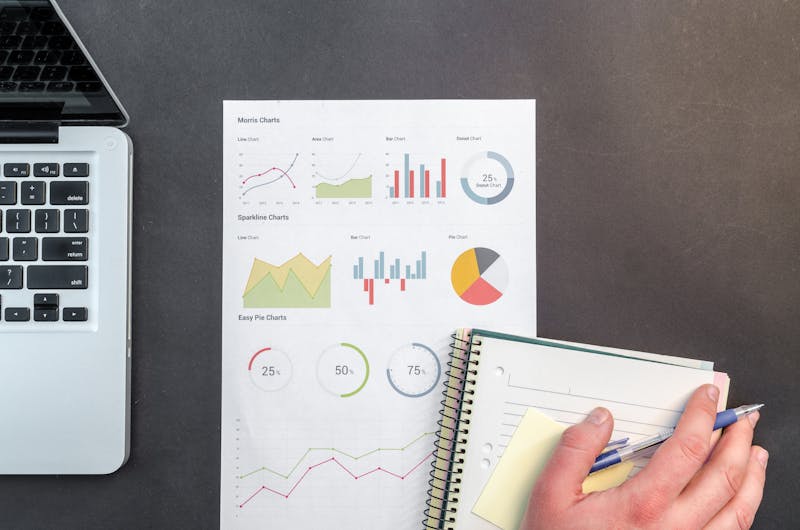
Analista revisando gráficos de posiciones y consultas en una pantalla

Dos URLs compitiendo por la misma consulta es más común de lo que parece en tiendas online y medios digitales. En muchos proyectos el problema lleva meses activo sin que nadie lo haya señalado, porque el tráfico total no cae: simplemente se reparte entre páginas que se estorban entre sí.

La canibalización aparece cuando varias páginas del mismo sitio responden a intenciones de búsqueda muy parecidas. Google alterna entre ellas según la semana, ninguna consolida autoridad y el resultado es una posición media que no termina de subir. En catálogos con categorías, filtros y etiquetas, ese solapamiento se genera casi sin querer.

Cómo se detecta con datos de Search Console

El primer paso es cruzar el informe de Rendimiento con la lista de URLs. Filtramos por consulta y observamos cuántas páginas distintas reciben impresiones para la misma búsqueda. Cuando aparecen dos o tres URLs con clics repartidos de forma irregular a lo largo del tiempo, hay una señal clara.

Conviene revisar también la evolución mensual: si la URL que posiciona cambia sin que se haya tocado el contenido, el buscador está eligiendo entre candidatas equivalentes. Los logs del servidor ayudan a confirmar qué páginas rastrea con más frecuencia y cuáles quedan relegadas.

Patrones de arquitectura que la provocan

  • Categorías y subcategorías que describen el mismo producto con variaciones mínimas de texto.
  • Etiquetas generadas automáticamente que replican el contenido de la categoría principal.
  • Versiones con parámetros de filtro indexables que compiten con la URL limpia.
  • Artículos de blog que atacan la misma intención que una página de servicio.

Qué decisiones suelen resolverla

No hay una receta única. En algunos casos basta con consolidar dos URLs en una mediante redirección y reescribir el contenido para cubrir la intención completa. En otros, la página secundaria tiene suficiente valor propio y conviene diferenciarla: cambiar el enfoque, ajustar el título y separar los enlaces internos para que cada una reciba señales distintas.

Cuando dos URLs conviven bien, suele ser porque responden a matices distintos de la misma consulta: una informativa y otra transaccional, por ejemplo. Forzar la fusión en ese escenario puede hacer perder tráfico. La decisión se toma con datos, no por norma.
Cuaderno de auditoría

Notas de trabajo sobre rastreo, indexación y arquitectura

Publicamos lo que vamos encontrando en revisiones reales: cobertura en Search Console, páginas excluidas, errores de rastreo y cruces con logs del servidor. Sin promesas de posiciones, solo hallazgos y cómo se ordenan.

Analista revisando gráficos de posiciones y consultas en una pantalla

Arquitectura y consultas

Canibalización de keywords: cómo detectarla antes de que frene tu posicionamiento

La canibalización aparece cuando varias páginas del mismo sitio responden a intenciones de búsqueda muy parecidas y Google alterna entre ellas sin consolidar autoridad. En proyectos con categorías, filtros y etiquetas es habitual que el problema pase desapercibido durante meses. Revisamos cómo detectarla con datos de Search Console, qué patrones de arquitectura la provocan y qué decisiones de consolidación, redirección o reescritura suelen resolverla sin perder tráfico. También explicamos cuándo conviene dejar convivir dos URLs y cuándo no.

Leer la entrada
Pantalla con métricas de rendimiento web y gráficos de tiempos de carga

Rendimiento

Core Web Vitals en pymes: qué medir primero y qué puede esperar

Las métricas de experiencia de página influyen en la percepción del usuario y, en ciertos casos, en la evaluación del buscador. En pymes y tiendas con recursos limitados, la clave está en distinguir entre problemas que afectan a plantillas completas y detalles que solo aparecen en páginas secundarias. Repasamos cómo leer datos de campo frente a datos de laboratorio, qué mejoras suelen tener mayor retorno y cómo coordinar al desarrollador sin frenar el resto del proyecto. Incluye ejemplos de decisiones que se pueden posponer sin riesgo.

Leer la entrada
Fragmento de código con etiquetas de datos estructurados en un editor

Marcado y plantillas

Datos estructurados: errores frecuentes que impiden que se muestren en resultados

Los datos estructurados ayudan a describir el contenido de una página, pero su efecto depende de que exista coherencia entre el marcado y lo visible. En auditorías técnicas encontramos con frecuencia tipos mal elegidos, propiedades incompletas o información duplicada entre plantilla y contenido editorial. Explicamos cómo revisar el marcado con las herramientas del buscador, qué errores suelen pasar la validación sin ser efectivos y cómo mantener el sistema cuando el sitio crece. También abordamos el caso de medios digitales con artículos y autores.

Leer la entrada

Usamos cookies para mantener el sitio estable, recordar opciones basicas y entender que paginas resultan utiles. Puedes aceptar, rechazar o revisar la configuracion antes de continuar.